U eri velikih podataka, prenosnih jezera pojavile su se kao moćno rješenje za organizacije za pohranjivanje i analizu ogromnih količina podataka. Kao jedan red dobavljača često nailazim na pitanje: može li se jedan red koristiti u jezeru podataka? Ovaj post bloga ima za cilj istražiti ovo pitanje u dubini, pružajući uvid u izvodljivost, koristi i razmatranja korištenja pojedinačnih redaka u okruženju jezera u podacima.
Razumijevanje podataka
Prije nego što se unosite u upotrebu pojedinačnih redaka u podatkovnim jezerima, važno je shvatiti šta je jezero podataka. Data jezero je centralizirano skladište koje pohranjuje sve vrste podataka - strukturirano, polustrukturirano i nestrukturirano - na skali. Omogućuje organizacijama da prikupe podatke iz više izvora, poput transakcijskih sistema, društvenih medija, senzora i još mnogo toga. Za razliku od tradicionalnih skladišta podataka, za koje su potrebne podatke da budu pre - strukturirani i modelirani prije skladištenja, jezera podataka čuvaju sirove podatke u svom matičnom formatu, omogućavajući fleksibilniji istraživanje i analizu podataka.


Koncept pojedinačnih redaka u jezeru podataka
Jedan red u jezeru podataka odnosi se na pojedinačni zapisnik unutar skupa podataka. U relacijskoj bazi podataka, red obično predstavlja jedinstveni entitet ili događaj, sa stupovima koji predstavljaju različite atribute tog entiteta. U jezeru u datovima, pojedinačni redovi mogu doći iz različitih izvora i mogu imati različite šeme. Na primjer, jedan red bi mogao biti zapisnik o kupcu iz platforme E - trgovine, čitanje senzora sa IOT uređaja ili unosa dnevnika sa web servera.
Izvodljivost korištenja pojedinačnih redaka u jezeru podataka
Kratki odgovor je da, pojedinačni redovi mogu se koristiti u jezeru podataka. Jezera podataka dizajnirana su za rukovanje različitim formatima i strukturama podataka, čineći ih dobro - prilagođenim za pohranu pojedinačnih zapisa. Evo nekih razloga zašto je korištenje pojedinačnih redova u jezeru podataka izvedivo:
1. Fleksibilnost
Podacijski jezera ne primjenjuju krutu shemu. To znači da pojedinačni redovi s različitim shemama mogu koegzistirati unutar istog jezera podataka. Na primjer, ako prikupljate podatke iz više naslijeđenih sustava, svaki sustav može imati svoj način strukturiranja podataka. U jezeru podataka možete pohraniti pojedinačne retke iz ovih sistema, a da ih odmah ne morate pretvoriti u zajedničku shemu.
2. Pravi - gutanje podataka
Mnoge moderne aplikacije generiraju podatke u stvarnom - vrijeme, jedan zapis po jedan. Na primjer, IOT uređaji kontinuirano šalju očitanja senzora, a sustavi financijskih trgovanja trenutno generiraju pojedine trgovinske evidencije. Podatkovno jezero može gutati ove pojedinačne redove kako se generiraju, omogućuju organizacijama da snimi i analiziraju stvarne podatke o vremenu bez čekanja za obradu paketa.
3. GRANULARNA ANALIZA
Jednokrevetni redovi pružaju najbrojniji nivo podataka. Čuvanjem pojedinačnih zapisa u jezeru podataka, analitičari mogu izvršiti detaljnu analizu na rekordnom nivou. Na primjer, u scenariju marketinškog analitike analiziranje pojedinačnih transakcijskih redaka može pomoći u prepoznavanju specifičnih ponašanja kupaca, sklonosti i trendova.
Prednosti upotrebe pojedinačnih redova u jezeru podataka
Korištenje pojedinačnih redova u jezeru podataka nudi nekoliko prednosti:
1. Poboljšana tačnost podataka
Skladištenje podataka na nivou pojedinog - redova osigurava da su dostupne informacije najtačnije i gore - do - datume. Budući da svaki red predstavlja specifičan događaj ili entitet, postoji manje prostora za pogreške na združivanju podataka koje se mogu pojaviti pri rezimiranju podataka na višem nivou.
2. Poboljšana sljedivost podataka
Jednokrevetni redovi olakšavaju traženje porijekla i povijesti podataka. U jezeru za datovanje može se povezati s metapodacima koji pruža informacije o njegovom izvoru, vrijeme prikupljanja i bilo kakvim transformacijama koje se pretrpi. Ova sljedivost je ključna za potrebe upravljanja i usklađenosti podataka.
3. Podrška za naprednu analitiku
Mnoge napredne tehnike analitike, poput mašinskog učenja i duboko učenje, zahtijevaju podatke na individualnom rekordnom nivou. Spremanjem pojedinačnih redaka u jezeru podataka, organizacije mogu iskoristiti ove tehnike kako bi stekli precizniji uvidi i poboljšaju - informirane odluke. Na primjer, u otkrivanju prevara, analiziranje pojedinačnih redaka transakcija može pomoći u prepoznavanju obrazaca i anomalija koje mogu ukazivati na lažne aktivnosti.
Razmatranja kada koristite pojedinačne retke u jezeru podataka
Iako postoji mnogo koristi za korištenje pojedinačnih redaka u jezeru podataka, postoji i neka razmatranja:
1 Skladištenje i performanse
Spremanje velikog broja pojedinačnih redaka može konzumirati značajan prostor za pohranu, posebno ako podaci nisu pravilno komprimirani ili optimizirani. Uz to, upitaju pojedine retke mogu biti sporiji u odnosu na upit agregirani podaci. Da bi se riješila ova pitanja, organizacije mogu koristiti tehnike kao što su pregrade podataka, indeksiranje i kompresiju za poboljšanje efikasnosti skladištenja i performansi upita.
2. Upravljanje podacima
Upravljanje pojedinačnim redovima u jezeru podataka zahtijeva robustan okvir upravljanja podacima. Budući da pojedinačni redovi mogu doći iz više izvora i imati različite sheme, važno je osigurati kvalitetu, sigurnost i poštivanje podataka. To uključuje definiranje vlasništva nad podacima, kontrole pristupa i procese line podataka.
3. Evolucija shema
Kako se dodaju novi izvori podataka ili se mijenjaju postojeći izvori podataka, shema pojedinačnih redova može se razviti s vremenom. Data jezera moraju biti u mogućnosti da se izrade evolucije sheme kako bi se izbjegla problemi sa kompatibilnim putem podataka. To se može postići tehnikama kao što su shema na čitanju, gdje se shema primjenjuje kada se podaci čitaju, a ne kada je napisano.
Naši pojedinačni redni proizvodi za prenosnih jezera
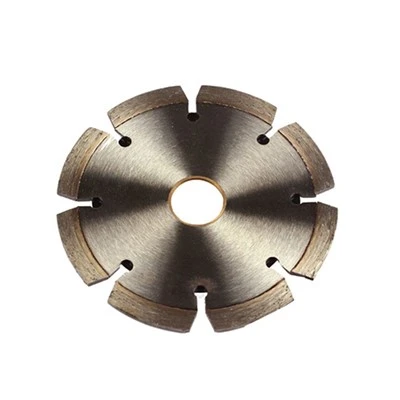
Kao jedan red dobavljača nudimo niz proizvoda koji su posebno dizajnirani za rad sa jednim redovima u podatkovnim jezerima. NašKontinuirani obori za brušenjeJe li visoko performans alat koji može podnijeti izazove obrade pojedinačnih redova. Optimizirana je za brze gutanje podataka i može efikasno obrađivati pojedinačne zapise iz različitih izvora.
NašNovo oblikovanje dijamantskih kotača za mljevenje kotača za tvrdi mramorje još jedan inovativni proizvod koji je dobro - pogodan za jezera za podatke. Pruža fleksibilno i skalabilno rješenje za pohranu i analizu pojedinačnih redova, omogućavajući organizacijama da se prilagode promjeni zahtjeva za promjenom podataka.
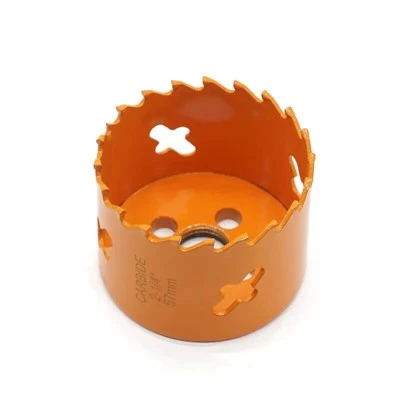
Pored toga, našeVisokokvalitetni kotač za šalicu 125mm Dijamantni brusni poličar kotača za beton Granitne brušenjeNudi napredne funkcije za upravljanje podacima i optimizacijom performansi. Pomaže organizacijama efikasno upravljati pojedinačnim redovima, osiguravajući kvalitetu podataka i sigurnost tijekom poboljšanja performansi upita.
Zaključak
Zaključno, pojedinačni redovi se mogu efikasno koristiti u jezeru podataka. Nude fleksibilnost, stvarne mogućnosti gutanja podataka i podršku za granularne analize. Međutim, organizacije trebaju pažljivo razmotriti skladištenje, performanse, upravljanje podacima i evoluciju sheme kada koriste pojedinačne retke u okruženju jezera podataka. Kao jedan red dobavljača, posvećeni smo pružanju visokog kvaliteta proizvoda i rješenja koje pomažu organizacijama da maksimalno postave pojedinačni redovi u svojim podacima.
Ako ste zainteresirani za učenje više o tome kako naši pojedinačni proizvodi mogu imati koristi od vašeg jezera podataka, ohrabrujemo vas da nas kontaktirate za raspravu o nabavci. Naš tim stručnjaka spreman je da vam pomogne u pronalaženju najboljih rješenja za vaše specifične potrebe.
Reference
- Jain, A., & Dubey, A. (2019). Jezera podataka: koncepti, tehnologije i velike analitike podataka. CRC Press.
- Kimball, R. i Ross, M. (2013). Alat za skladište podataka: Definitivni vodič za dimenzionalno modeliranje. Wiley.
- Stonebraker, M., & Hellerstein, JM (ur.). (2018). Čitanja u sistemima baza podataka. MIT Press.